Data Live es un programa en vivo que trae para ti a ingenieros y científicos de datos de renombre, para llevarte paso a paso a través de las tecnologías más nuevas y útiles en este fascinante mundo de la ciencia de datos.
Regresa Data Live con miras a preparar el camino hacia Data Day Monterrey 2022. En el primer episodio de esta temporada platicaremos sobre el enfoque de contenidos que tendrá esta edición del evento, que es la primera en realizarse de forma presencial desde 2019.
¡Agrégalo a tu calendario!
14 de septiembre 19:00 hrs. (hora Ciudad de México)
En ocasiones parece que Computer Vision sólo es detección de objetos, pero es mucho más, hay muchas vertientes para especializarte dentro de esta área como Percepción 3D, Procesamiento de imágenes o todas las nuevas aplicaciones que involucran Machine Learning, así que porqué limitarnos sólo a una cuando hay tanto potencial por explotar con diferentes aplicaciones de computer vision que influyen en cualquier lugar.
Actualmente es profesor de cátedra en el Tecnológico de Monterrey, es Senior Data Scientist en NovaComp y es Co-Director de DataLab Community.
Acerca de Rubén Álvarez
Egresado de la carrera de ingeniería en Biónica por parte de la UPIITA del IPN.
Realizó su maestría y doctorado en Ciencias Computacionales en el Cinvestav Unidad Guadalajara. Rubén es un apasionado del área de Inteligencia Artificial como Machine Learning, Computer Vision y Sistemas Expertos. Con experiencia en la academia e industria como Intel Labs, Skycatch, Carbon Robotics y Dyoo desarrollando sistemas de Computer Vision.
En esta ponencia hablaremos de cómo implementar una metodología para el desarrollo de modelos de Machine Learning para generar una herramienta para el análisis descriptivo que pueda responder lo que está sucediendo en el mercado y crear visualizaciones estratégicas en Python que permitan a los usuarios estudiar las propiedades de los datos y tomar las medidas adecuadas antes de construir cualquier modelo predictivo.
Requisitos:
Nivel básico en programación en Python
Entendimiento de estadística básica
Instalación de Python 3.5 o superior
Uso de algún IDE como: Visual Studio Code (puedes contar con Anaconda).
Acerca de Alejandro Ballesteros:
Doctorado en Ciencia Aplicada y Tecnología Avanzada enfocado en la investigación, desarrollo e implementación de modelos de inteligencia artificial para el descubrimiento de patrones de conocimiento que describan los distintos escenarios y/o correlaciones de las variantes dentro de un conjunto de datos con el objetivo de presentar diversas alternativas que conlleven a la solución de un problema o la toma de decisiones.
Ya sabemos que al desarrollar un modelo, debemos de seleccionar bien nuestros features para maximizar poder predictivo. También hemos escuchado que “más datos superan a un modelo muy sofisticado”. Igual hemos visto que muchos de nosotros tomamos todas nuestras variables y así se las aventamos al modelo, obteniendo relaciones e inferencias espurias.
El concepto del bias-variance tradeoff es lo que nos pone en el justo medio de estas 3 situaciones, y es el concepto más, más, más importante de Machine Learning, y al cual se le dedica poco tiempo en universidades, y nadita en bootcamps.
Vamos a ver como funciona este trade-off con una simulación en R.
Acerca del ponente
Ingeniero en Sistemas Computacionales por el ITESM y Maestro en Computational Finance por la Universidad de Nottingham.
+18 años de experiencia en el sector tecnológico de México y ha liderado sistemas de importancia nacional como el Sistema de Liquidación de Valores para Indeval y el MoNeT para índices de mercado para Bolsa Mexicana de Valores. Ha tenido posiciones de liderazgo en Ciencia de Datos y Analytics en empresas importantes del sector financiero y bursátil.
Fue cofundador y Director de Operaciones en Datank.ai, startup dedicada a automatizar decisiones operativas mediante Machine Learning. También es cofundador de The Data Pub, la comunidad de profesionales de ciencia e ingeniería de datos más grande de México con más de 2000 miembros. Es Vicepresidente de la Sociedad Mexicana de Ciencia de Datos, organización de la sociedad civil dedicada a la educación y sensibilización del mercado sobre Ciencia de Datos y Machine Learning para empresas, talento y academia. Es catedrático en arquitecturas de datos en la licenciatura de Ciencia de Datos del ITAM. Actualmente dirige el Centro ITAM para Datos + Algoritmos + Sociedad, el cual propone soluciones a problemas sociales desde la Ciencia de Datos para lograr decisiones más justas, equitativas y transparentes sobre recursos públicos limitados.
El seguir buenas prácticas de programación en R y alinearnos a una metodología de trabajo (SCRUM) nos han permitido mantener modelos estadísticos y comunicar resultados a clientes en un esquema automatizado y robusto. Además, esto posibilita actuar con rapidez en la resolución de bugs en producción y así minimizar errores que se traducen en tiempo y posibles pérdidas económicas. Esto permite mantener múltiples análisis y actualizarlos de forma automatizada.
Como parte de esta plática mostraremos la creación de un paquete en R con los elementos y estructura necesarios para ser puesto en producción.
Acerca de las ponentes:
Nancy Morales Landa
Senior Analytics Developer en el equipo de Product Development en Kantar. Licenciada en Actuaría por la Facultad de Ciencias de la UNAM. Ha trabajado en Investigación de Mercados por más de 4 años desde un enfoque estadístico y de ciencia de datos. La implementación de sus análisis ha sido mayoritariamente en R. Entre sus intereses principales está la automatización de procesos, código abierto y ambientes de producción. Actualmente está cursando el Diplomado en Data Science and ML applied to Financial Markets en el ITAM.
Mariana Carmona Baez
Part time Senior Analytics Developer en el equipo de Product Development en Kantar. Maestra en Ciencia de Datos y licenciada en Matemáticas Aplicadas, ambos por el ITAM. Cuenta con 7 años de experiencia en Investigación de Mercados. Trabaja principalmente en R y Stan. Forma parte del comité organizador de R-Ladies Ciudad de México. Sus intereses principales son estadística Bayesiana y fomentar la diversidad de género en los lenguajes de programación. Actualmente se encuentra estudiando el doctorado en Quantitative Life Sciences en McGill University.
Desde la idea de utilizar un modelo de aprendizaje automático, hasta su despliegue en un ambiente productivo y su posterior monitoreo, los procesos robustos y las buenas prácticas de ingeniería de software son fundamentales para asegurar su calidad y su correcto funcionamiento.
MLOps (Machine Learning Operations) surge para intentar cubrir aquellos aspectos donde la ingeniería es necesaria para garantizar la comunicación entre científicos de datos e ingenieros de aprendizaje automático. En esta charla veremos de qué va el tema de MLOps, sus distintos componentes y veremos utilizar uno de los frameworks más utilizados en Python (Flask) en conjunto de contenedores para el despliegue de un modelo de aprendizaje automático.
Acerca de Carl Wallace Handlin:
Actual Head of Data Science and Artificial Intelligence para Rappi Pay. Más de 7 años de experiencia en el área de ciencia de datos, aprendizaje automático e inteligencia artificial. Maestría en ciencias de la computación por el Tecnológico de Monterrey. Experiencia en Fintech, InsurTech y PropTech. Entusiasta del código abierto y de los datos abiertos. Programador en Python. Parte del comité organizador del Meetup “The Data Pub” para Ciudad de México.
SageMaker es una herramienta poderosísima y versátil, aunque solo disponible para AWS. No es cara, pero tampoco es gratis. Su poder reside en que con una interfaz muy amigable y conocida, podemos desarrollar productos de ciencia de datos de punta a punta, es decir, desde la adquisición de datos, hasta la envoltura de un modelo de machine learning en un API para habilitar predicciones continuas y sobre todo, recolección de datos de la realidad de negocio cambiada por las sugerencias de nuestro modelo.
En este Live desarrollaremos un proyecto de punta a punta con SageMaker.
Nivel: básico a intermedio.
Acerca del Ponente
Adolfo Martínez González es Lic. en Mates Aplicadas por el ITAM. Ha consultado para Metros Cúbicos en modelos de pricing y segmentación de clientes, para Grupo Expansión en productos periodísticos y editoriales basados en datos y para Grupo Bursátil Mexicano con sistemas de recomendación de inversiones y roboadvisors. En datank.ai fue líder de investigación aplicada donde desarrolló mecanismos para formulación de grafos de conocimiento desde esquemas relacionales. Colabora en proyectos especiales como Sr. Data Scientist con la Sociedad Mexicana de Ciencia de Datos. Actualmente es Technical Mentor en el Centro ITAM para Datos + Algoritmos + Sociedad, desde donde se proponen soluciones con Ciencia de Datos a problemas sociales, y Sr. Data Scientist en Globant, donde desarrolla modelos de machine learning para las industrias de real estate, retail y hospitality.
Esta charla toca el primer tema de una serie de artículos que, de manera muy simple, intenta introducirnos al uso de diferentes nubes y servicios para crear soluciones efectivas de obtención, almacenamiento y transformación de datos; y cómo mostrar esta información al cliente de una manera rápida y fácilmente accesible.
Aprenderás a desarrollar una solución low-code para manejo de datos masivos. Para ello, es recomendable que tengas:
Una cuenta de Azure (puede ser estudiante o capa gratuita también).
Si no cuentas con una cuenta gratuita no te preocupes, el ejercicio es de poco costo y puedes eliminar los recursos después.
Preferible tener una cuenta de PowerBI (hay una cuenta pro gratis de 60 días).
Acerca de Juana Martínez:
Ingeniera en Sistemas Computacionales.
CoFundadora de Women in data science, power and engineering
CoDirectora en el Health Data Science Program
Consultora en Innova Analytics donde participa en distintos proyectos para distintas empresas a nivel nacional e internacional.
Me encanta participar en diversas comunidades e iniciativas que facilitan el conocimiento de manera libre, que incentivan a la curiosidad y el deseo de saber en sus miembros.
“Creo que otorgar en un proyecto o empleo la libertad de ser uno mismo, de vivir la creatividad en favor de las ideas y soluciones, siempre debe ser parte de cualquier contrato”.
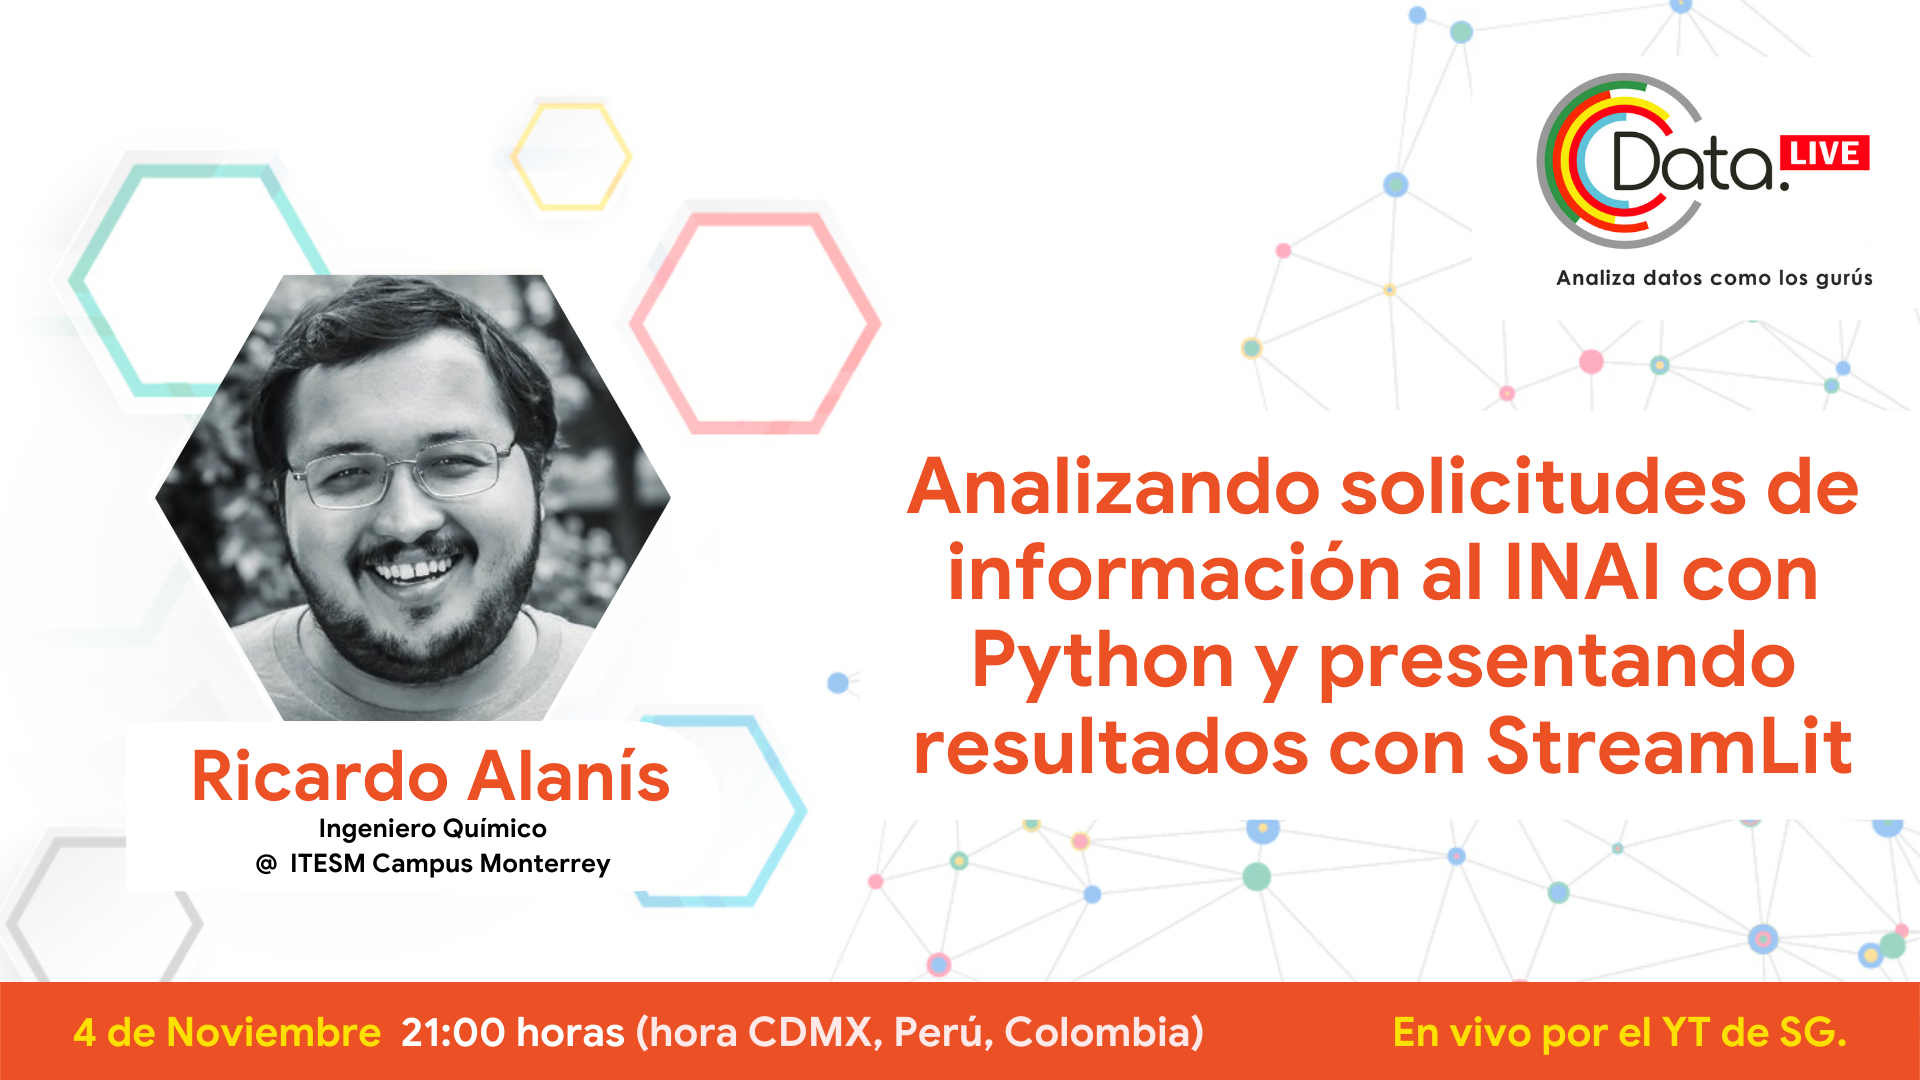
Tenemos una mina de oro en una plataforma que está como maldita desde que nació: La plataforma nacional de transparencia. Un acervo de datos sobre solicitudes nos esperan, para poder entender el uso de la herramienta actual y hacia donde podría ir. Discutamos sobre la parte técnica, obtener los datos, agruparlos y presentarlos de manera atractiva, pero preguntémonos el valor de datos tan interesantes expuestos de una manera no accesible ni atractiva.
Acerca del ponente
Ricardo es un apasionado del poder de los datos para todas las personas, organizaciones e instituciones. Empezó como ingeniero químico, pero se dio cuenta que la visión de proceso podría ser llevado a muchas dimensiones si existieran datos. Empezó su carrera en Codeando México, para luego unirse a la spin off de Cívica Digital. Hoy, participa en la empresa Nowports en donde tiene la misión de dar inteligencia de última generación a una industria con cientos de años de historia. Ricardo ama participar en comunidades y proyectos de su localidad, apoyando a startups en crecimiento, a personas a empezar su camino en datos y compartiendo en comunidades como Data Science Monterrey, Hacking Health, entre otras.